「AIが人類を脅かす? それほど賢くはない」
ⓒ 中央日報/中央日報日本語版2026.10.13 12:02
「人工知能(AI)は人類を脅かすほど賢くない」。
AMIラボのヤン・ルカン会長は12日、ソウル市内のホテルで行った中央日報とのインタビューでこのように話した。最近広がっている「AI終末論」に対し彼は「(現在の主流である)大規模言語モデル(LLM)は自身の行動がどのような結果につながるのか予測できず、その結果が人間にどんな影響を及ぼすかもわからない。人間なら10歳の子どもでもわかること」と説明した。
――最近韓国ではAIハッキング事故が相次いで起きている。
「基本的に企業が不注意なためだ。AIエージェントを配布した開発会社のセキュリティ経験が不足し、AIを閉じ込めておく隔離環境(サンドボックス)には弱点があった。AIを統制できなくて発生した事故ではない。サイバーセキュリティの問題とみるべきだ」。
――AIの逸脱事例も出ている。
「難しい問題ではない。エンジニアリング(工学)で解決すれば良い。AIに命令を下した瞬間に安全装置が作動する『目標指向型AI』として設計しなければならない。人間が設定した目標以外の突発行動はできないAIを意味する。包丁を持つロボットに『周囲に人がいれば腕を振り回さないこと』という規則を設定する形だ」。
――いま出ているAIにも適用できるか。
「LLMの場合、ユーザーの個別の命令に対応する規則を細かく微細に調整するのは難しい。そのためAIの『逸脱』が頻繁に起きるのだ。オープンAIのサム・アルトマンCEOが速度調節を強調しながら次期モデルを出さない理由もここにある。十分に微細調整されていないと感じるからだ」。
――ベンジオ氏とヒントン氏もAI終末論を主張するが。
「2人ともAIが人間を上回ることを仮定して話すが同意しない。いまのAIは人間が蓄積した知識を集合し、これを繰り返すことにすぎない。自己検証が可能な数学、コーディングなど限定的な領域を除けばそれほど賢くない」。
――それではAIはどの点が危険なのか。
「過度な独占が問題だ。現在大多数の人がAIを経て情報を習得するが、そのシステムを少数の企業が独占すれば世界の価値・言語多様性は失われる。情報が行き来する経路を握ったダリオ・アモデイ(アンソロピックCEO)の『AIは本質的に危険だから統制しなければならない』という形の主張は蒙昧主義(知識拡散を防ぐ態度)に近い。過去にオスマン帝国の君主が印刷機の配布を防いだのと似ている」。
――ワールドモデルは何が違っているか。
「ワールドモデルはLLMと違い行動結果を予測できはるかに賢くなるだろう。目標指向型AIとして設計し、統制をするのもより容易だ。AIが賢いからと統制できないという考えは間違いだ」。
最新記事
포토뷰어
「AIが人類を脅かす? それほど賢くはない」
2026.10.13 12:02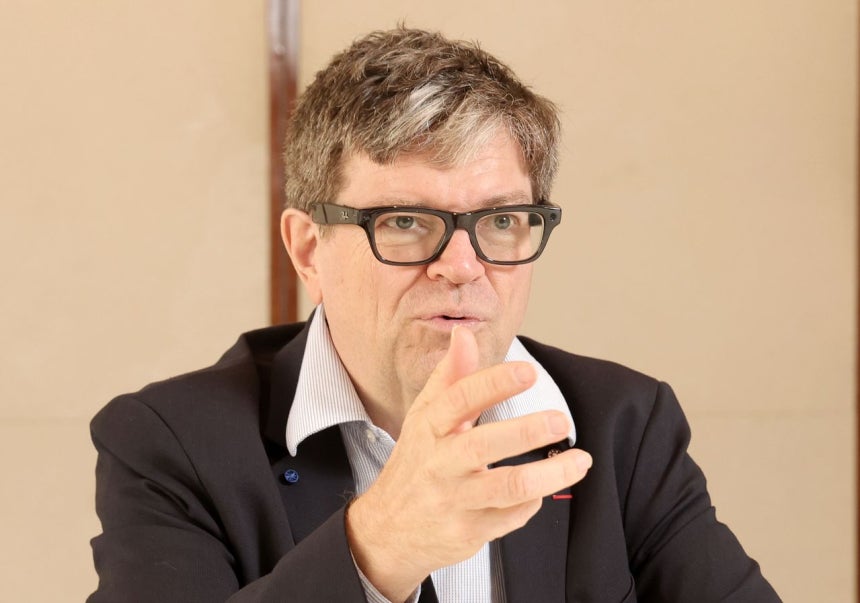
AMIラボのヤン・ルカン会長が12日にソウル市内のホテルで中央日報とインタビューしている。カン・ジョンヒョン記者